高校信息中心的运维痛点高度一致:校区多、设备品牌杂、机房分散,而专职运维往往只有 1–3 人,预算有限却又被要求"设备不出事、出事能溯源"。选型一旦失误,后期要么告警刷屏淹没真问题,要么数据库膨胀把页面拖垮,再推倒重来成本极高。本文面向院校信息化处、信息中心决策层,客观对比 Zabbix 与 Prometheus+Grafana 两套主流开源监控栈,给出一套可直接用于立项评审的选型框架。所述方案基于原生开源组件验证:Zabbix 6.0 LTS(MySQL/MariaDB 后端)、Prometheus 2.x + Grafana 10.x。风险提示:动手前务必先梳理一份《监控对象清单》并预估日均告警量,避免凭感觉选型、上线后被动返工。
一、两栈的本质差异:一体化 vs 组合式
Zabbix 是"一体化监控平台":采集、存储、告警、基础可视化在同一个产品内闭环,开箱即用程度高。Prometheus 是"时序采集+存储引擎",自身不含完整 UI 与告警分发,需要 Grafana 补可视化、Alertmanager 补告警路由,属于"组合式栈"。理解这一点就不会用错评判标准——拿 Zabbix 的"功能多"去比 Prometheus 的"弹性好",其实不在同一维度。
二、关键维度对比
| 维度 | Zabbix 6.0 LTS | Prometheus + Grafana |
|---|---|---|
| 数据采集 | 主动/被动 Agent、SNMP、IPMI、HTTP 等,内置丰富模板 | 拉模型 Exporter(node_exporter 等),需自行布点 |
| 存储引擎 | MySQL/MariaDB 关系库,长期稳定、易备份 | 本地 TSDB,长期存储需 Thanos / M3DB 扩展 |
| 告警能力 | 内置 Action、升级、脚本执行,开箱完整 | 需 Alertmanager 做路由/抑制/静默 |
| 可视化 | 自带图形偏弱,通常接 Grafana | Grafana 原生强,面板生态丰富 |
| 运维门槛 | 配置即所得,学习曲线平缓 | 组件多,K8s 场景优势明显但门槛更高 |
| 适用规模 | 百级~数千节点稳态环境 | 云原生、弹性、高 cardinality 指标场景 |
三、校园场景下的取舍
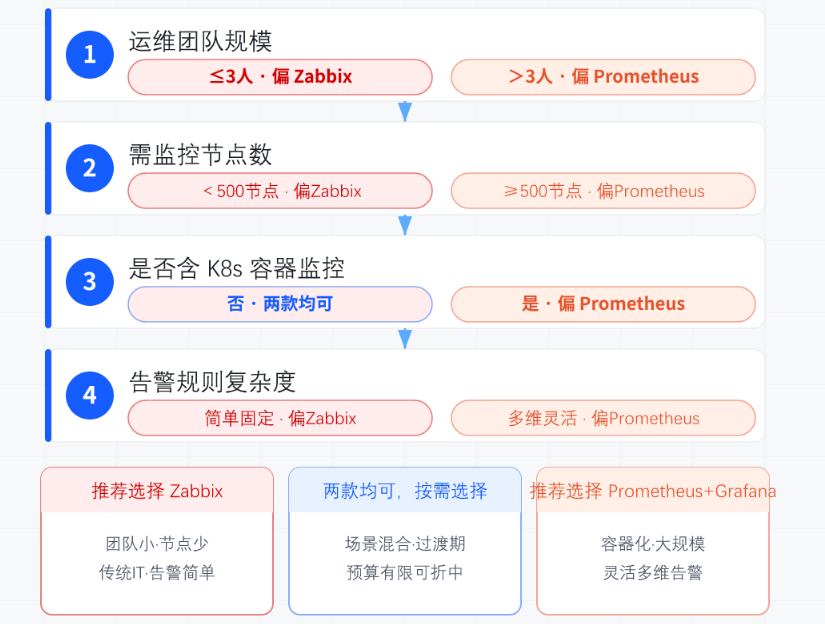
< 300 节点、以物理机/虚拟机/网络设备为主:优先 Zabbix。一套平台覆盖采集到告警,人力少也能 hold 住,无需额外拼接组件。
大量 K8s/容器、业务弹性扩缩:优先 Prometheus 栈,其拉模型与标签体系天然适配动态实例,扩容无需改采集配置。
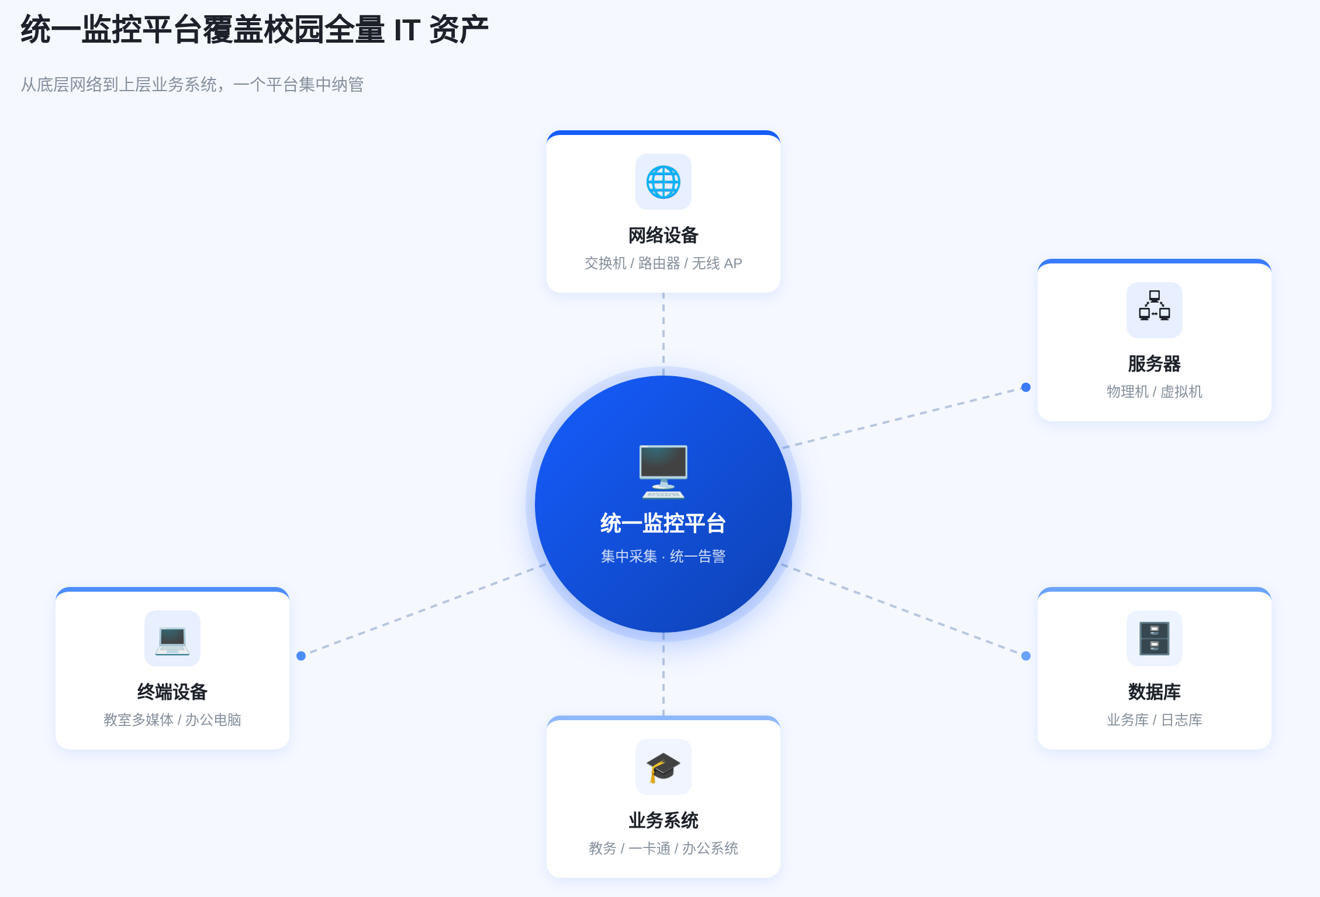
混合现状(多数高校):以 Zabbix 为主采集稳态资源,前端统一用 Grafana 出图,既省力又好看,不必强行二选一。某高校 200+ 节点实践中,Zabbix 主采集 + Grafana 统一展示的组合稳定运行两年以上。
四、选型决策框架
按四项打分:①运维团队人数(≥3 人可驾驭组合栈);②被管节点数(<300 偏 Zabbix);③是否含 K8s(含则加分给 Prometheus);④告警复杂度(需升级/值班轮转则 Zabbix 内置 Action 更省心)。三项及以上指向同一栈,即可立项,不必再纠结。
盲目上 Prometheus 却无 K8s 经验:组件多、概念重,反而比 Zabbix 更费人,结果用一半就荒废。
忽略 Zabbix 数据库容量规划:上线不设历史保留期,半年后 history 表膨胀至数百 GB,页面卡死、备份困难。
把两栈当对立:其实可 Zabbix 采集 + Grafana 展示共存,没必要非此即彼。
只比功能不比团队:选了"更强"的栈但没人长期维护,最终监控形同虚设。
选型没有绝对优劣,只有是否适配团队与场景。对人力有限、以稳态设备为主的高校,Zabbix 是更稳的起步;云原生比重高再考虑 Prometheus。先把《监控对象清单》列清楚,选型自然清晰。
若你正在为院校规划开源运维监控平台、纠结选型与架构,可联系我们获取基于开源监控栈的选型与可视化方案咨询。